机器人训练数据正在分裂:运动交给仿真,操作还留在真机
为什么读:被引用最多的那组对照,并不是它被引用的那个意思。
文|Embodied AI Frontier
2026 年 9 月 17 日至 11 月 4 日,三条机器人训练数据路线在七周内先后公布了一份评测成绩:Figure 用众包人类视频预训练的系统在 30 个陌生家庭完成 56% 的全任务,苹果用全仿真数据训练的系统在 6 个陌生家庭取得 91% 的单任务成功率,BEHAVIOR 挑战赛的冠军用真机遥操作数据在仿真环境中取得 48.2% 的全任务成功率。
三份成绩单被称为同一个词,零样本,测的却是三类任务、三种数据来源与两套度量方式。
行业自 2026 年 4 月起反复引用的一组对照,软件模拟环境成功率 89.4%、家庭任务成功率 12%,经溯源为两个仿真基准之间的差异,并非仿真与现实的对照;两者的任务集与成功算法均不同,不存在可以直接相减的差值。同一批试验内换用部分得分与全成两种算法,读数相差十四个至二十个百分点。
差异的物理来源落在接触环节:机器人身体如何移动已可由仿真数据单独训练,手部与环境接触之后的动力学参数仍须真实交互才能观测。
未来两年的观察点可收拢为五项:评测指标是否分化、真机数据的计价单位是否转向标定、生成式仿真是否越过物理一致性门槛、开源代码是否达到可复现等级、触觉与失败样本是否成为独立考点。
本文结构
- 一、三份公开成绩单的任务差异
- 二、评测口径的溯源与修正
- 三、接触环节的技术约束
- 四、2026 年的五条技术趋势
- 五、中国数据基础设施的两条路线
- 六、结论:分界线的位置与观察方向
一、三份公开成绩单的任务差异
1.1 三条数据路线的任务与结果
2026 年 9 月 17 日,美国机器人公司 Figure 公布 Helix 2.5 的评测结果:在加州湾区 30 个从未采集过数据的出租屋内,机器人完成铺床、叠毛巾与收纳玩具三类家务,四百二十次完整任务试验中成功 237 次,全任务成功率 56%。同一批材料给出的对照组显示,在任务示范数据、模型架构、训练参数与评测方式保持一致的条件下取消 Index 平台预训练,成功率降至 9%17Helix 2.5: Zero-Shot 30-Home Generalization点击查看文末条目 →。两组结果由同一套评测流程得出,意味着 56% 这一数字中有相当部分来自预训练阶段的通用知识,任务示范数据本身并不能单独撑起这一水平。
七周之后,苹果研究团队于 11 月 4 日在预印本平台 arXiv 提交论文《Perceptive Humanoid Motion from Simulation》,披露人形机器人自主控制系统 HALO。研究使用一台宇树科技生产的 G1 人形机器人,在六个未预先扫描、未建立地图的真实家庭中执行六项运动技能,每项技能在每处环境重复十次,累计三百六十次试验,单任务平均成功率 91%。系统全部模型在机身运行,机体背部搭载一台 Mac mini,默认不接入网络,这一部署形态说明推理成本这一侧已不再依赖云端算力1Perceptive Humanoid Motion from Simulation点击查看文末条目 →6苹果披露人形机器人 HALO 系统:调用千问模型在宇树 G1 上验证点击查看文末条目 →。
同期的另一份公开成绩来自赛事评测。第二届 BEHAVIOR 挑战赛于 11 月上旬公布结果,任务由五十项扩充至一百项,场景由三个扩充至七个,参赛者由 96 人增至 265 人,提交由 18 份增至 57 份。冠军队伍全任务成功率 48.2%,而 2025 年那一届赛事的同一指标为 12.4%。两个数字不能直接相减:任务集由五十项扩至一百项,场景由三个增至七个,单集时限由人类平均时长的两倍收紧至一点五倍,赛道由双轨改为单轨。参赛队 Robot Learning Collective 公开的一处对照显示,在去年那五十项任务上,其 Q-score 由 0.260 升至 0.371,而时限缩短了四分之一11官方排行榜点击查看文末条目 →12One Policy for 100 Household Tasks: Our Solution for the 2026 BEHAVIOR Challenge点击查看文末条目 →,这一跃升不能归因于任务集变简单。
表1(Table 1)三条数据路线的训练数据与公开结果(公布时间:Figure 2026-09-17,后两者 2026-11-04)
| 路线 | 训练数据与任务 | 公开结果 |
|---|---|---|
| Figure Helix 2.5 | 众包人类视频预训练加少量真机示范;铺床、叠毛巾、收纳玩具 | 30 个陌生家庭零样本 56%(237/420),无预训练基线 9% |
| 苹果 HALO | 一千个程序生成家庭、三百小时全仿真;六项运动技能 | 6 个陌生家庭单任务 91%,串联 70%,三动作串联 50% |
| BEHAVIOR 2026 | 每任务 200 条真机遥操作示范、合计 1,950 小时;100 项长程家务 | 冠军 48.2%,2025 年同指标 12.4% |
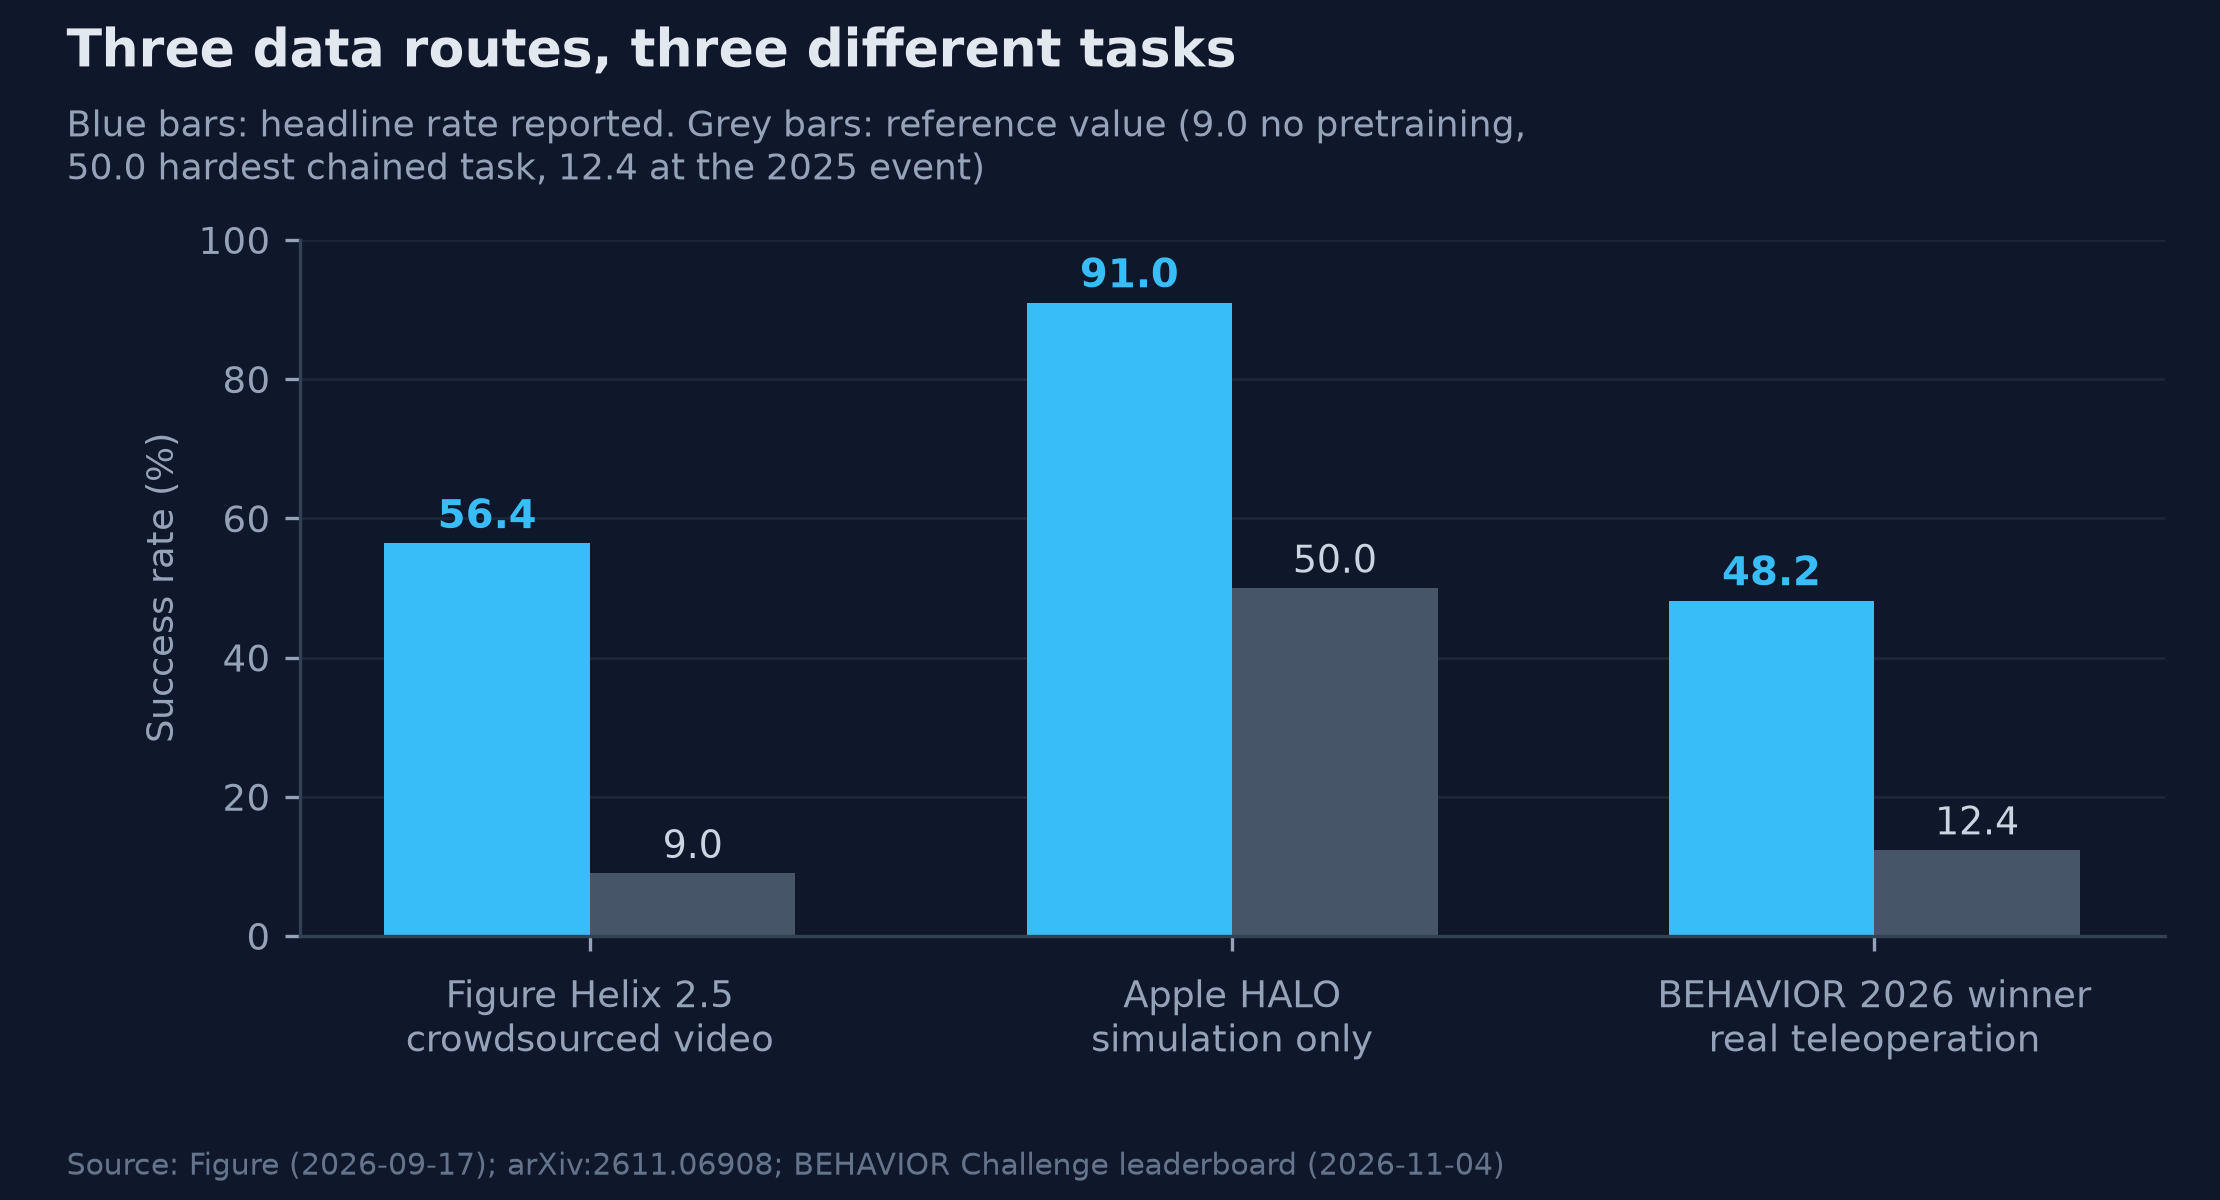
图1 三条数据路线对应的任务类型与报告成绩
资料来源:Figure(2026-09-17);arXiv:2611.06908;BEHAVIOR Challenge 官方榜单(2026-11-04)
1.2 长程串联成功率的落差
三份成绩单之间不存在可直接比较的关系,原因在于任务构成而非数字本身。苹果那套系统在六项单技能上的分布相当集中,逐项数值取自论文结果表1Perceptive Humanoid Motion from Simulation点击查看文末条目 →5Apple's HALO Teaches a Unitree G1 to Navigate Unseen Rooms With Simulation-Generated Data点击查看文末条目 →:钻过桌底的成功率为百分之百,侧身穿过半开门为 93%,走到指定物体为 92%,坐到椅子上为 85%。这些动作的共同特征是接触时刻短暂、接触对象单一、失败代价接近零,与工业场景中的连续工序并不在同一层级,后者对接触的连续性要求高出一个数量级1Perceptive Humanoid Motion from Simulation点击查看文末条目 →。
同一套系统进入长程任务后表现明显下滑。论文给出的复合任务评测在单一真实环境中进行,三种动作组合各重复十次,平均成功率 70%,其中难度最高的一组为俯身穿过障碍、走向目标、把箱子推开,十次试验成功五次。论文对此给出的解释是:串联失败的主要原因是上一步结束时机器人的朝向或位置不适合下一步,而系统未内置发现偏差后回退重试的行为2HALO 项目主页点击查看文末条目 →。
BEHAVIOR 赛事的任务定义恰好落在串联这一侧。一百项任务的平均人类演示时长为 5.9 分钟,评测时限为人类平均时长的 1.5 倍,任务中断后不设二次机会,因此 48.2% 对应的能力是连续完成一项完整家务的概率12One Policy for 100 Household Tasks: Our Solution for the 2026 BEHAVIOR Challenge点击查看文末条目 →。把这一指标与苹果的单技能 91% 并列,落差来自任务结构:单技能衡量的是动作能否被准确执行,长程任务衡量的是动作序列能否在偏差累积后仍然收敛,两者的提升路径也因此不同,前者靠动作精度,后者只能靠失败恢复与状态估计。
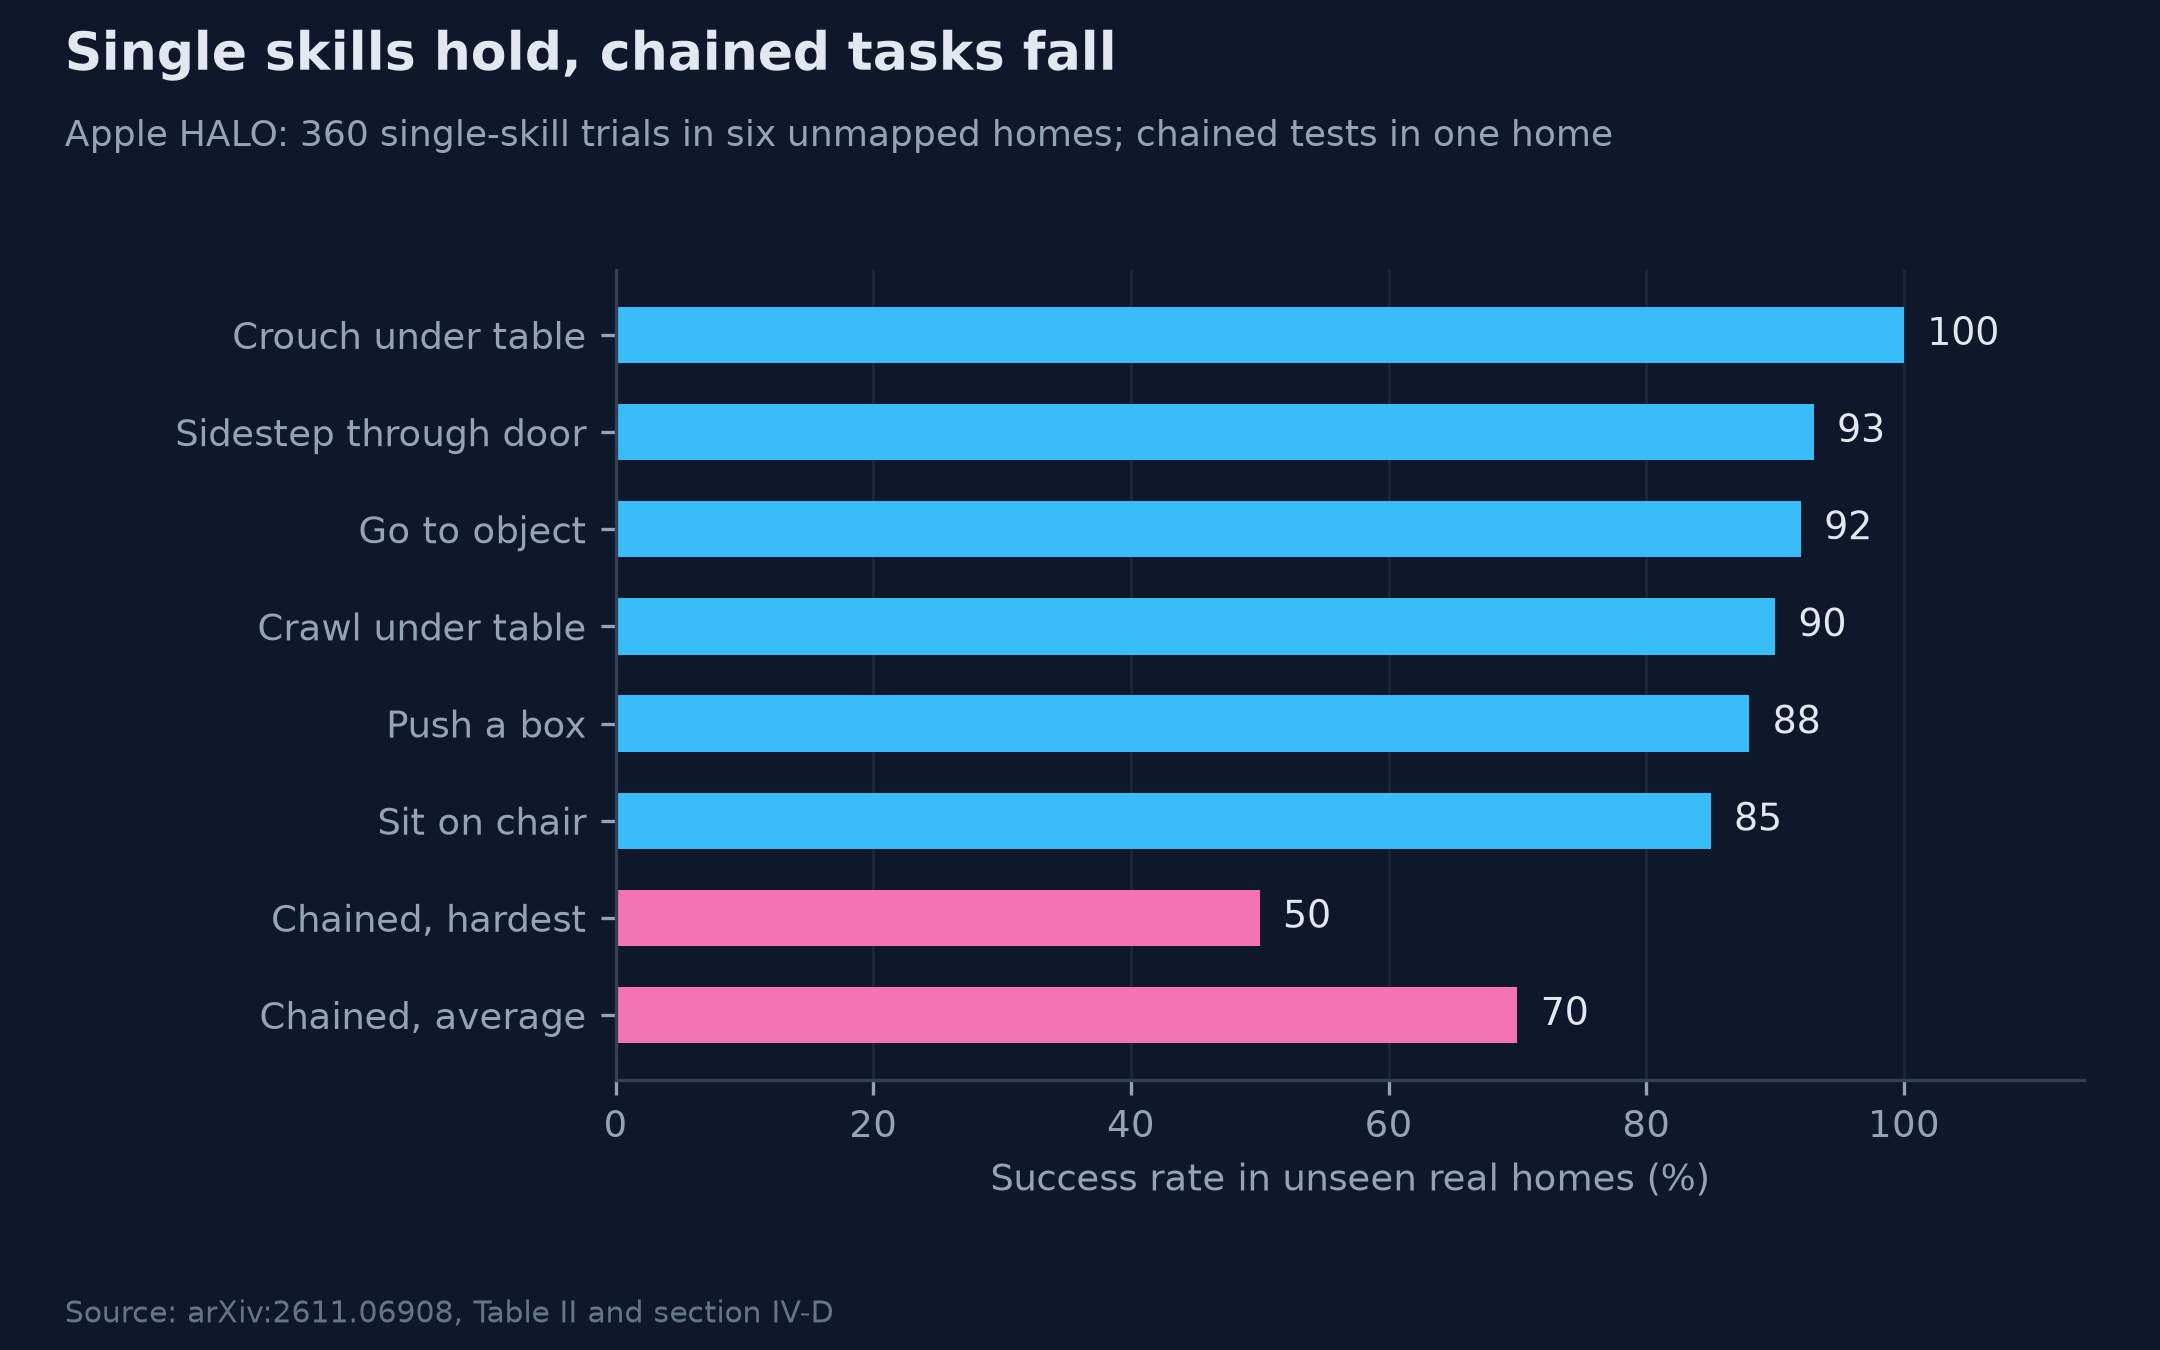
图2 苹果 HALO 单技能与串联任务的成功率
资料来源:arXiv:2611.06908,表 II 与第四节
二、评测口径的溯源与修正
2.1 两组数字的基准与指标
2026 年 4 月,斯坦福大学以人为本人工智能研究院(Stanford HAI)发布《AI Index Report 2026》。报告第二章第 116 页与第 117 页给出两组被此后半年反复引用的数据:软件模拟环境中的机器人操作成功率为 89.4%,家庭任务中的完全成功率为 12%8《AI Index Report 2026》技术表现章节点击查看文末条目 →9《AI Index Report 2026》完整报告 PDF点击查看文末条目 →。
两组数字分别来自不同的评测体系。89.4% 出自 RLBench,一个包含十八项短程任务的机器人操作基准,每项任务提供一百条人类示范,创造这一成绩的方法为 EquAct,指标为十八项任务的平均成功率,报告同页给出的限定是这些基准测试的是相对短程的任务且发生在受控的仿真环境中,此前一版领先方法 SAM2Act 的成绩为 86.8%8《AI Index Report 2026》技术表现章节点击查看文末条目 →。
12% 对应的原始数值为 12.4%,出自 BEHAVIOR-1K,一个由一千项家庭活动构成的长程移动操作基准。报告第 116 页对该基准的定义为「a simulation benchmark」,第 117 页写明其测试条件为「long-horizon mobile manipulation challenges in simulated home environments」,12.4% 是 2025 年那一届 BEHAVIOR 挑战赛冠军在隐藏测试集上的全任务成功率,其 Q-score 为 0.268《AI Index Report 2026》技术表现章节点击查看文末条目 →9《AI Index Report 2026》完整报告 PDF点击查看文末条目 →11官方排行榜点击查看文末条目 →。
两组数字均在仿真器内评测,差别落在任务时长、任务数量与完成标准上。把两者并置所得到的七十七个百分点,衡量的是短程任务与长程家务之间的难度差,并不构成仿真环境与真实环境之间的对照。
2.2 摘要层的信息损耗
两组数字在报告正文中分属两个小节与两张图表,从未出现在同一段落之内。把它们写入同一句话的是报告的两处摘要。第 9 页的 Top Takeaways 第 5 条写为「Robots succeed in only 12% of household tasks... On RLBench, robotic manipulation in software-based simulations has reached 89.4% success」,第 72 页的 Chapter Highlights 第 10 条将同一句改写为「12% of real household tasks」8《AI Index Report 2026》技术表现章节点击查看文末条目 →9《AI Index Report 2026》完整报告 PDF点击查看文末条目 →。
同一份报告在这两处都删去了仿真这一限定,第 72 页的表述进一步引入了 real 一词。这一损耗的影响可从两个方向观察:一方面,报告全文四百二十三页中 sim-to-real 一词出现零次,说明机构本身并未把这组数据命名为迁移缺口;另一方面,下游引用几乎一致地沿用了摘要层的表述,Forbes 在 2026 年 4 月 14 日的报道中写为「fully succeed safely at only about 12% of real household tasks」15Humanoid Robots' 88% Fail Rate: Completing Home Tasks点击查看文末条目 →,The Next Web 在同一时期的报道中用一句话完成了对照,「Robotic manipulation systems achieve 89.4% success in simulation but only 12% in real household tasks」16Stanford's AI Index finds China has nearly closed the performance gap点击查看文末条目 →。
下游引用普遍只保留数字而略去限定。措辞压缩到这一层之后,来源条件与两个基准的名称同时消失,剩下的只有一个可用于任何场景的数字。
2.3 度量方式的影响幅度
即使锁定同一批技术与同一批任务,度量方式的选择也会显著改变读数。BEHAVIOR 挑战赛的官方排名指标为 Q-score,即按目标条件满足比例计算的部分得分,而学界惯用的成功率按整项任务全成计数。2025 年那一届冠军的两个读数分别为 0.26 与 12.4%,2026 年那一届冠军为 0.683 与 48.2%,每组数字各自描述同一支队伍在同一批试验上的表现11官方排行榜点击查看文末条目 →12One Policy for 100 Household Tasks: Our Solution for the 2026 BEHAVIOR Challenge点击查看文末条目 →。
同一批试验换一种算法,读数相差十三点六个百分点与二十个百分点。 这一层差异在通行引用中从未被交代,而投入方向的判断直接取决于它:七十七个百分点指向仿真路线不可依赖、须扩大真机采集规模;一旦承认那七十七个点由两个不同基准相减而来,这个推论便失去起点。89.4% 与 12.4% 之间不存在可以相减的差值,因为它们不仅任务集不同,成功与否的计算方式也不同。
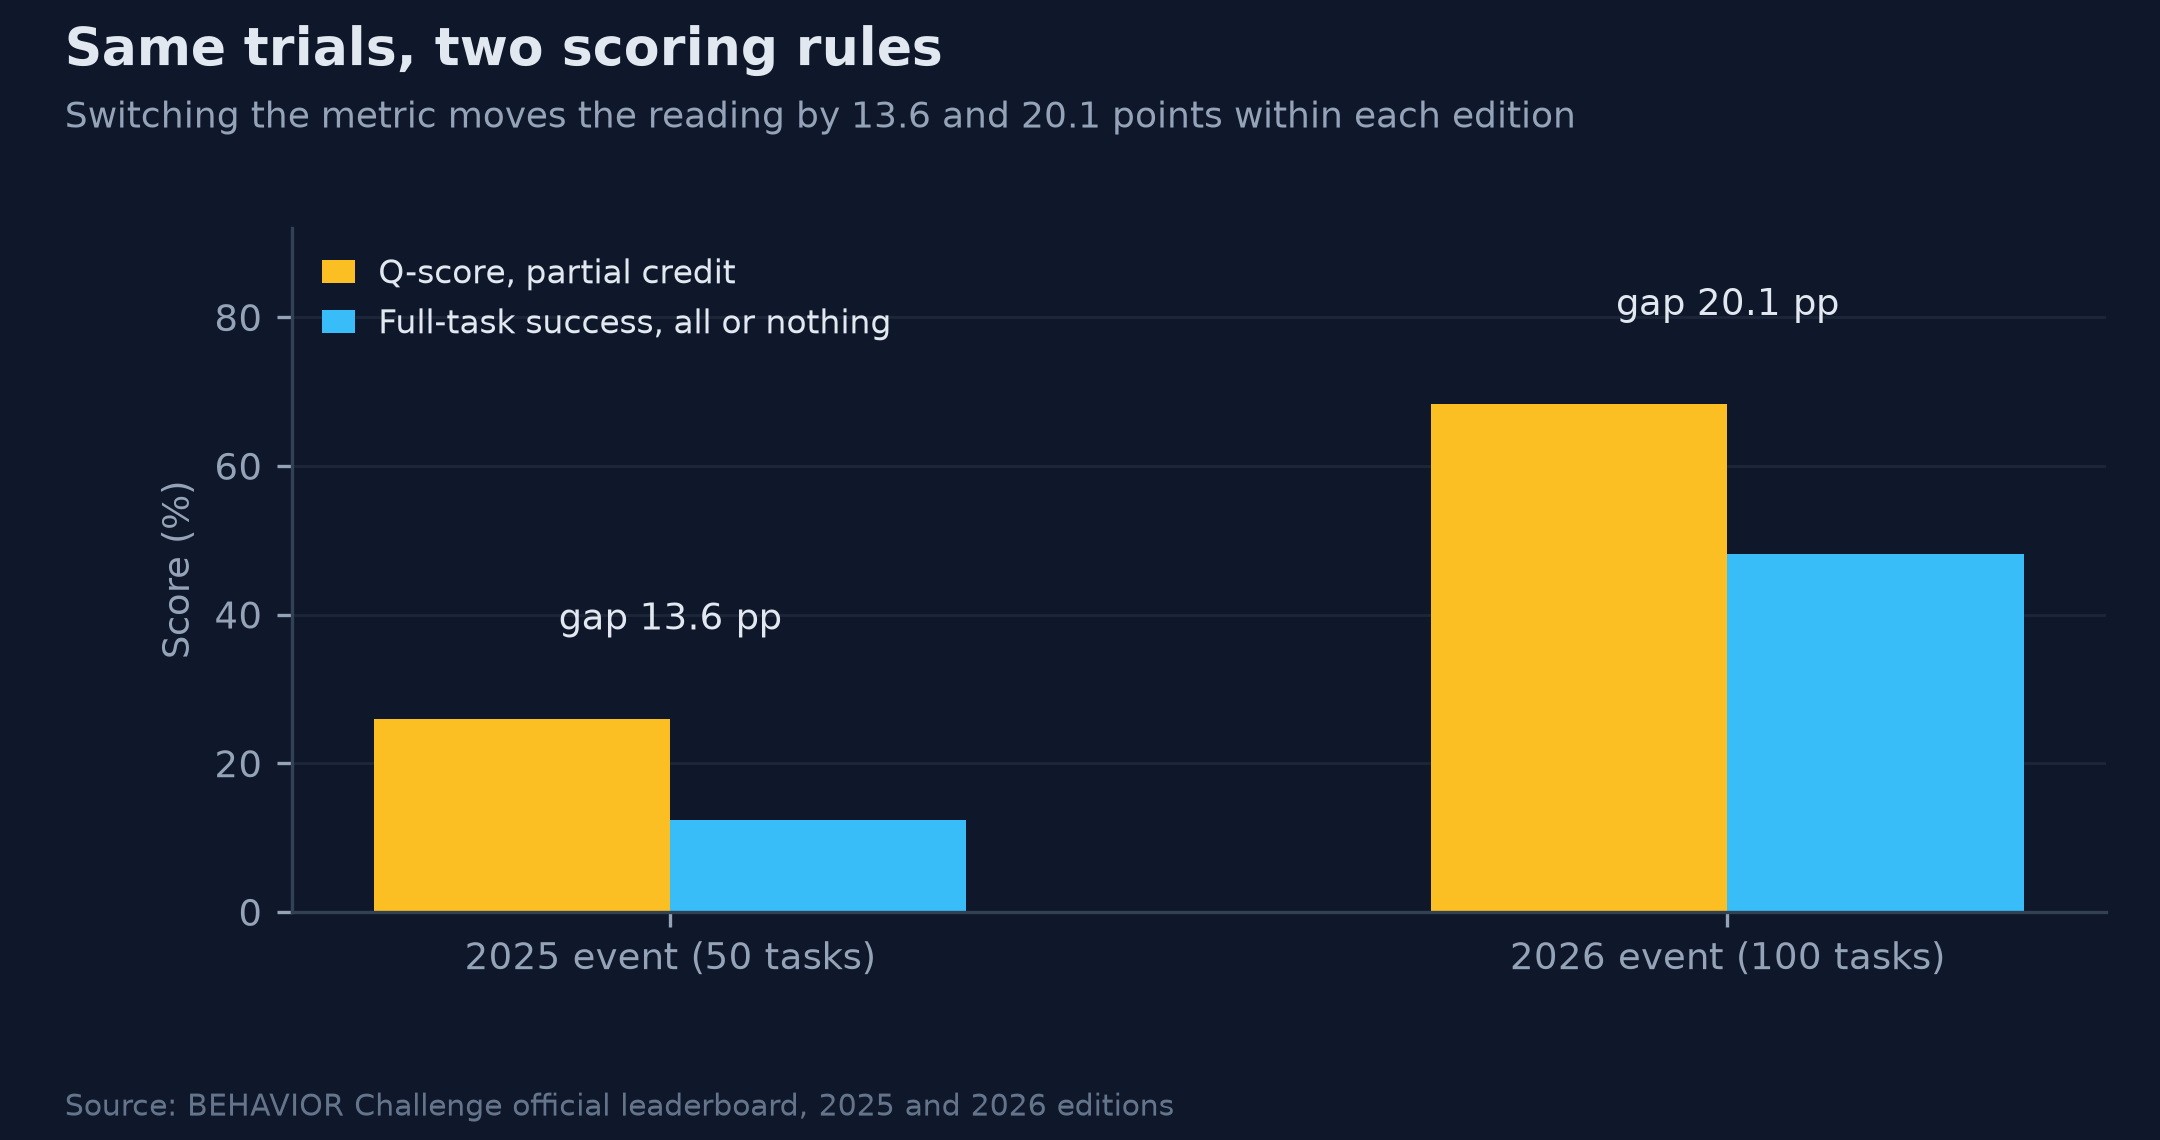
图3 同一批试验在两种计分规则下的读数
资料来源:BEHAVIOR Challenge 官方榜单,2025 届与 2026 届
2.4 基准内部的可选口径
89.4% 这一数值本身也不是该基准上唯一可取的读数。其原始出处为 EquAct 论文的表格,同一张表内,每任务一百条示范、平面移动条件下的成绩为 89.4%,每任务十条示范时为 60.1,加上三维移动后为 53.38《AI Index Report 2026》技术表现章节点击查看文末条目 →。报告选取最高单元格的做法与其回答的问题相符,即该基准上最好能做到多少,但当下游把这一数字当作该基准的普遍水平引用时,后两组配置便不再出现在讨论中。
该基准的成绩也没有停留在 89.4%。2026 年 8 月,同一批任务、每任务一百条示范的同等条件下,BridgeVLA++ 报告了 93.7% 的成绩,该结果由团队自行发布,尚无第三方复现14BridgeVLA++点击查看文末条目 →。这意味着行业引用了半年的这个数字,在被广泛引用时已经不是最新读数,而引用的滞后本身会放大对技术现状的误判。
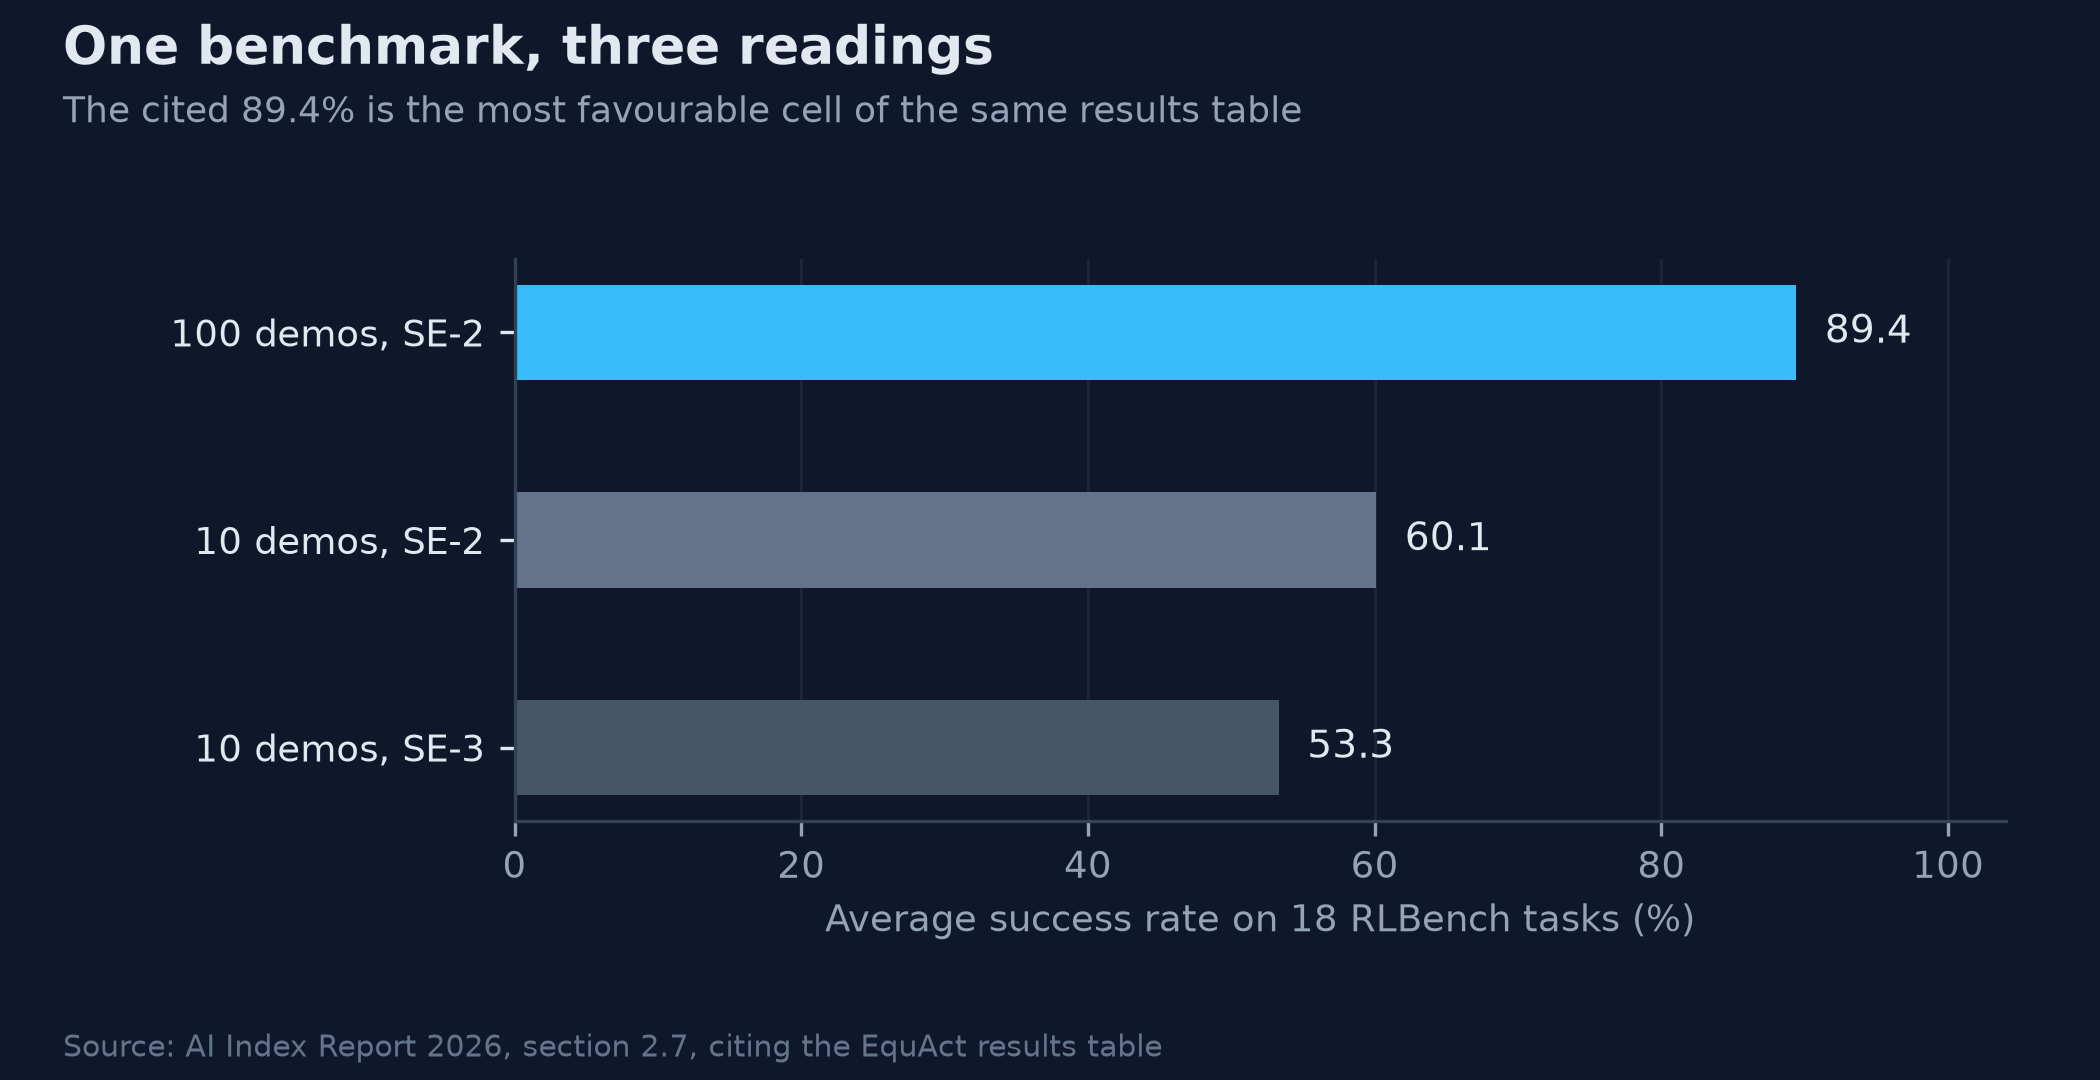
图4 RLBench 基准内部的三组取值
资料来源:AI Index Report 2026 第 2.7 节,转引 EquAct 结果表
2.5 三份成绩单各自的可核验状态
需要区分的是,三份成绩单本身并不存在数据虚构问题。89.4%、12.4% 与 48.2% 各自都能在其原始语境中复核,各自的持有者也都未夸大结论。BEHAVIOR 挑战赛的成绩分成两档,公开验证集上的成绩由参赛者自报,隐藏测试集上的成绩由组织方代跑并标注为 verified,榜单排名一律以验证档优先,即便自报档的分数更高11官方排行榜点击查看文末条目 →。